 1:27
Introduction en Bourse proposée d’Anthropic : distinguer l’annonce des affirmations financières
Un complément de lecture au Short de Luke et à l’annonce officielle S-1 d’Anthropic.
41 vidéos pour découvrir la méthode. Choisissez une vidéo pour voir ce qui a été essayé, les points à vérifier et par où commencer.
1:27Un complément de lecture au Short de Luke et à l’annonce officielle S-1 d’Anthropic.
 10:01
Connectez Perceptis à Claude, créez une présentation de cinq diapositives, affinez-en une et inspectez le texte, les formes et les données des graphiques modifiables dans Keynote.
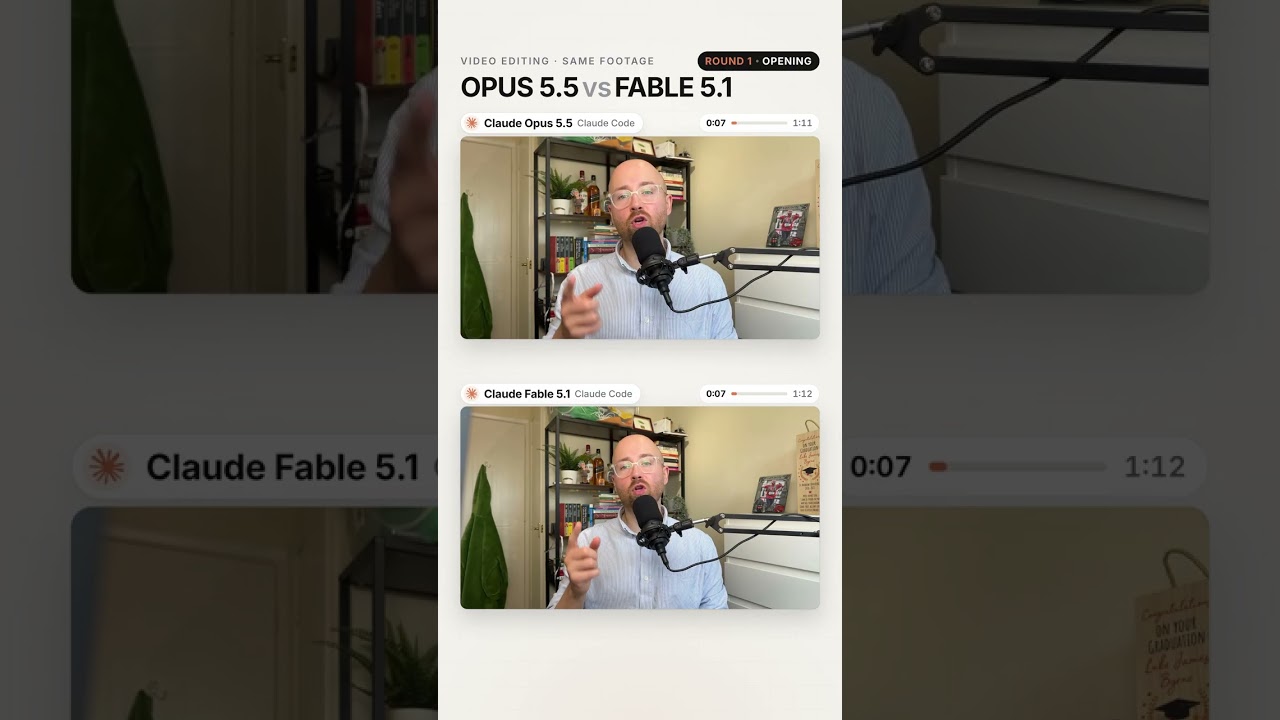 0:52
Comparez deux modèles Claude avec les mêmes rushes et la même skill de montage.
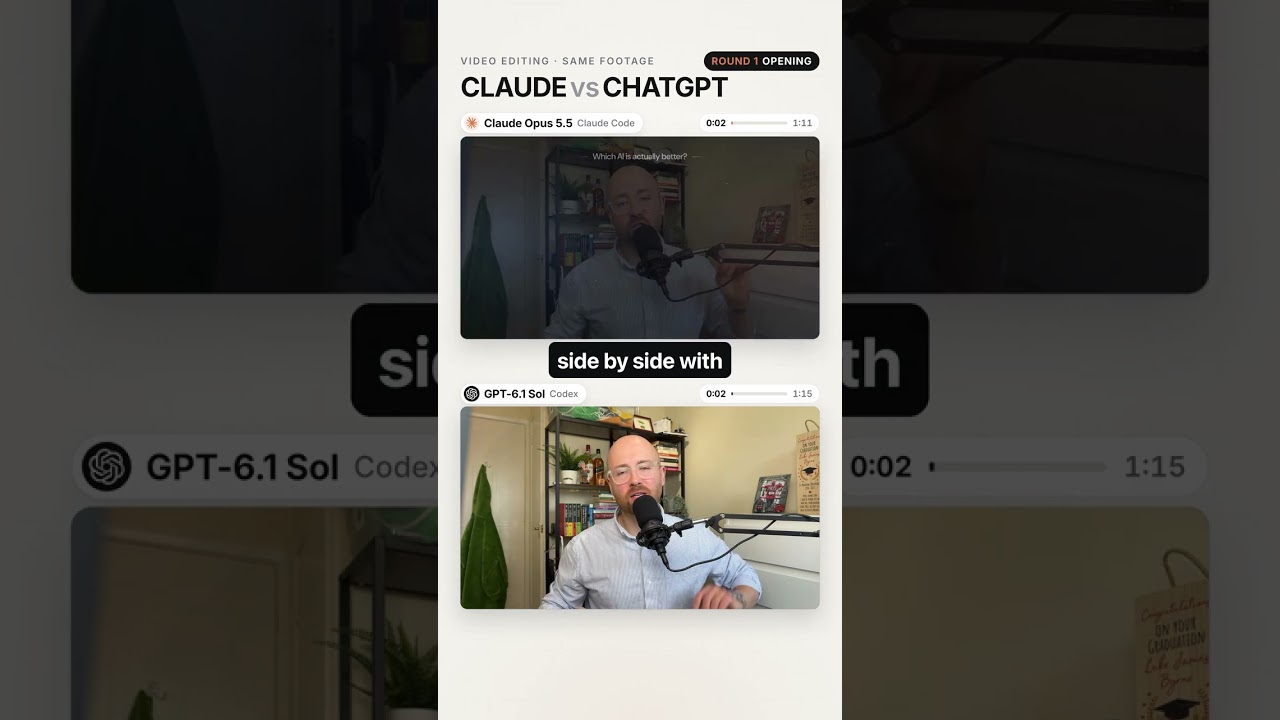 1:02
Comparez les montages de Claude et ChatGPT sur les mêmes séquences.
 11:27
Comparez quatre modèles sur les mêmes rushes et le même processus de montage enregistré, y compris coupes, graphismes et révisions.
 11:55
Planifiez l’action dans Blender, guidez Seedance 2.5 avec la référence exportée et comparez le résultat à l’essai textuel original.
 16:00
Passez de la recherche de références à une nouvelle création en gardant l’analyse des sources et les décisions de production examinables.
 17:01
Contrôlez les entrées, consignez les transmissions et jugez le mouvement final plutôt que de déclarer un gagnant universel.
 14:10
Créez une référence de mouvement simple, examinez la mise en place et comparez le même brief avec et sans ce guide.
 10:55
Examinez les images, précisez les mouvements de caméra et utilisez des coupes maîtrisées plutôt que des transitions fragiles entre les pièces.
 13:39
Utilisez les mêmes briefs, inspectez les vraies mises en page et vérifiez que le PowerPoint reste modifiable dans Canva.
 10:13
Commencez en lecture seule, inspectez le consentement et les fiches d’audience, puis examinez la campagne et l’automatisation avant l’envoi.
 9:25
Importez de manière sélective, étiquetez les souvenirs utiles et vérifiez ce qui est réellement envoyé à l’assistant suivant.
 0:46
Un complément écrit à la démonstration de bureau du Short, fondé sur une transcription automatique locale.
 28:31
Répétez une revue de code et une tâche web limitées, vérifiez les constats et séparez tarifs passés et qualité mesurée.
 26:25
Comparez quatre tâches de développement depuis un point de départ sauvegardé, en distinguant coût, périmètre et comportement visible de l’application.
 15:15
Utilisez la comparaison Scripti pour organiser les preuves sur bugs, interface et sécurité sans transformer les chiffres rapportés en classement universel des modèles.
 15:28
Lisez les affirmations historiques de recherche de bugs, corrections, refonte et audit de sécurité en conservant l’avis d’indisponibilité du modèle.
 15:20
Comparez une refonte de page, une revue de bugs et un audit d’infrastructure sur le même SaaS en gardant visibles les constats différents et le verdict combiné.
 13:48
Comparez les réponses des modèles, examinez les désaccords et distinguez mémoire importée et décisions tarifaires.
 12:26
Comparez séparément longueur du prompt et choix du modèle sur les mêmes tâches de jeu et de page.
 20:19
Examinez séparément design, rapports de bugs et compromis de fonctionnement dans une comparaison datée de trois modèles.
 9:55
Comparez quatre résultats de design et appliquez un système cohérent avant de considérer un prototype comme terminé.
 6:07
Distinguez contrôles intégrés et skill /go personnalisée de Luke, puis examinez un changement de bout en bout.
 8:58
Comparez Haiku, Sonnet et Opus sur la même tâche en suivant coût total, attente et utilité du résultat.
 9:40
Utilisez l’explication archivée pour distinguer capacités annoncées, benchmarks, restrictions d’accès et prévisions.
 8:35
Distinguez instructions réutilisables, connexions aux outils et ensembles de capacités avant de créer un rôle spécialisé.
 12:01
Utilisez la comparaison de mars pour examiner confort d’interface, accès terminal et exigences avant de changer vos habitudes.
 5:03
Comparez les scores de détection au sens et à la lisibilité réels des réécritures à partir des deux exemples enregistrés.
 6:30
Utilisez du vrai code pour créer un parcours utilisateur, ajoutez graphiques et explications interactives, puis inspectez la sortie sauvegardée.
 7:27
Choisissez boucle de session, tâche ordinateur ou GitHub Actions selon persistance et besoins d’exécution.
 7:13
Suivez la configuration Chrome et le test de leçons Skool en comparant modes de contrôle, résultat des modifications et échecs de navigation.
 5:37
Connectez le téléphone à la bonne session et distinguez contrôle distant et nouvelle session cloud.
 5:56
Utilisez le cadre de février pour comparer difficulté, qualité et révisions nécessaires à l’achèvement.
 23:09
Comparez trois niveaux de consignes sur la même page et distinguez jugement visuel et intégration.
 16:50
Examinez simulateur et fonctionnalité SaaS séparément, en notant échecs et utilisation près du travail terminé.
 16:04
Gardez visibles échec de construction, refonte réussie et utilisation historique dans le même examen.
 7:38
Examinez une modification via diffs, tests, Git et revue avant de passer aux agents parallèles.
 16:21
Collectez dans Sheets, testez le cloud et examinez les preuves derrière les sujets proposés par l’agent.
 8:20
Examinez exigences, contexte directeur et tâches avant l’implémentation générée.
 17:58
Distinguez processus déclenchés par MCP et nœuds communautaires, puis inspectez la configuration Claude Desktop fournie.